AIは「バグがない」を証明できるか。123のライブラリで進んだ形式検証
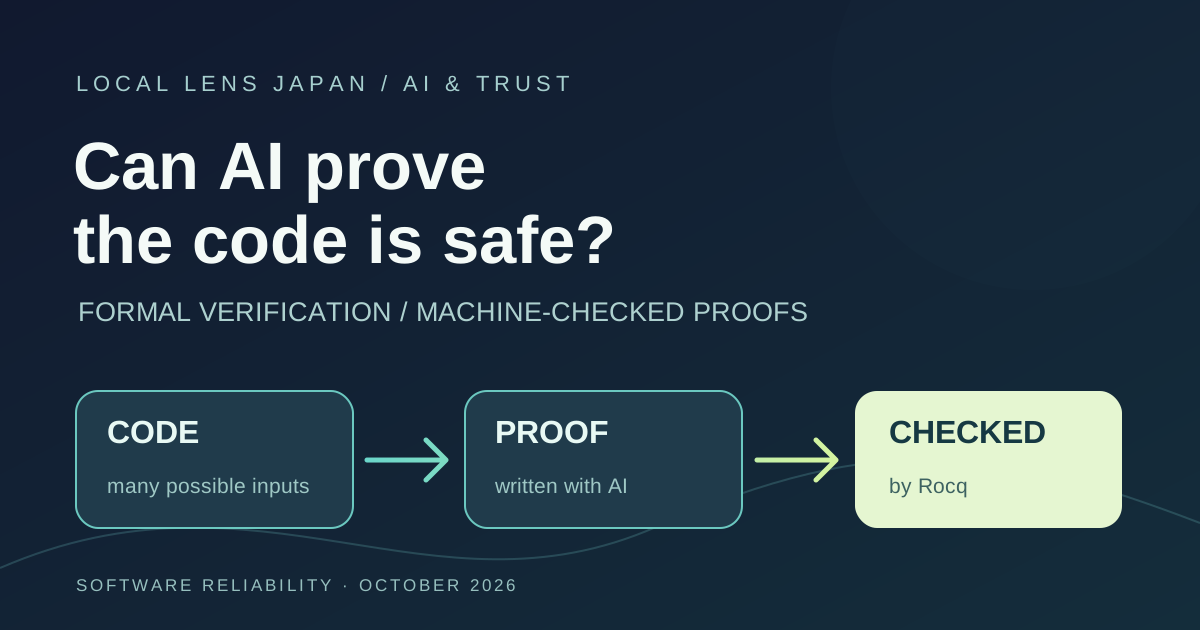
「テストを何百万回も通した」より、一歩踏み込んで「この条件では失敗しない」と証明できるか。Anthropicは10月22日、AIを使ってオープンソースのソフトウェアを形式的に検証した研究を発表した。Claudeが証明を組み立て、専用の検証器が正しさを機械的に確認する。AIが書くコードの量が増える時代に、品質をどう確かめるかを考える材料になる。
テストの「入口」を、証明の対象にする
通常のファズテストは、ランダムに変化させた入力を大量に与え、クラッシュを探す。役に立つ一方、試していない入力にも問題がないとは言い切れない。今回、Anthropicと共同研究先のTheoremは、既存のファズテストの入口ごとに「一定の条件下で、どの入力でもクラッシュしない」という命題を作った。
対象のプログラムをRISC-V向けの機械語に変換し、Claudeが数学的な証明を記述する。証明の判定はAIの自己採点ではなく、Rocqという証明支援系が行う。研究チームによると、GoogleのOSS-Fuzzに参加する123のライブラリで、239のテスト入口について証明を完成させた。入力の上限は64MBで、証明対象にはメモリ安全性の検査で起きるクラッシュなどが含まれる。
見つかった不具合と、証明できた範囲
証明を進める過程で、Claudeは既存コードの不具合も発見・修正したという。Anthropicが挙げる例には、約20MBの特定の入力で起こる展開処理の書き込み範囲外アクセスや、深く入れ子になった入力で起きるlibexpatの既知の脆弱性がある。大量の入力を試すテストでは見つけにくい経路を、証明の行き詰まりからたどれる点が興味深い。
ただし、ここでの「証明済み」を製品全体の安全保証と読んではいけない。中心となる実験は、固定のメモリ予算で動く、単一スレッドの静的リンクされたRISC-V/Linuxプログラムを前提とする。すべてのライブラリのすべての機能を検証したわけでもない。現実のx86やArm環境、別のOSの振る舞い、呼び出す側の誤用などは、この証明だけでは覆えない。命題やコンピューターのモデル自体が現実に合っているかも、人間が見極める必要がある。
AI時代の開発で、何を先に定義するか
日本のソフトウェア開発にも示唆がある。決済、医療機器、工場の制御など、失敗の代償が大きい場所では「AIがコードを書けるか」だけでなく、「満たすべき条件を明文化できるか」が重要になる。クラッシュしないこと、入力を復元できること、権限を越えないこと。検証したい性質を小さく定義し、既存のテストとつなげれば、形式検証を研究室だけの技術から現場の道具に近づけられる。
今回の研究は、その道が開きつつあることを示す一例だ。一方で、証明の作成には膨大な計算資源が必要で、適用範囲にも明確な境界がある。開発の次の競争は、コードを速く生むことに加え、どの約束を機械的に確かめられるかを設計することになる。
出典:Anthropicの研究発表(2026年10月22日)。数値と事例は研究チームの報告に基づく。